

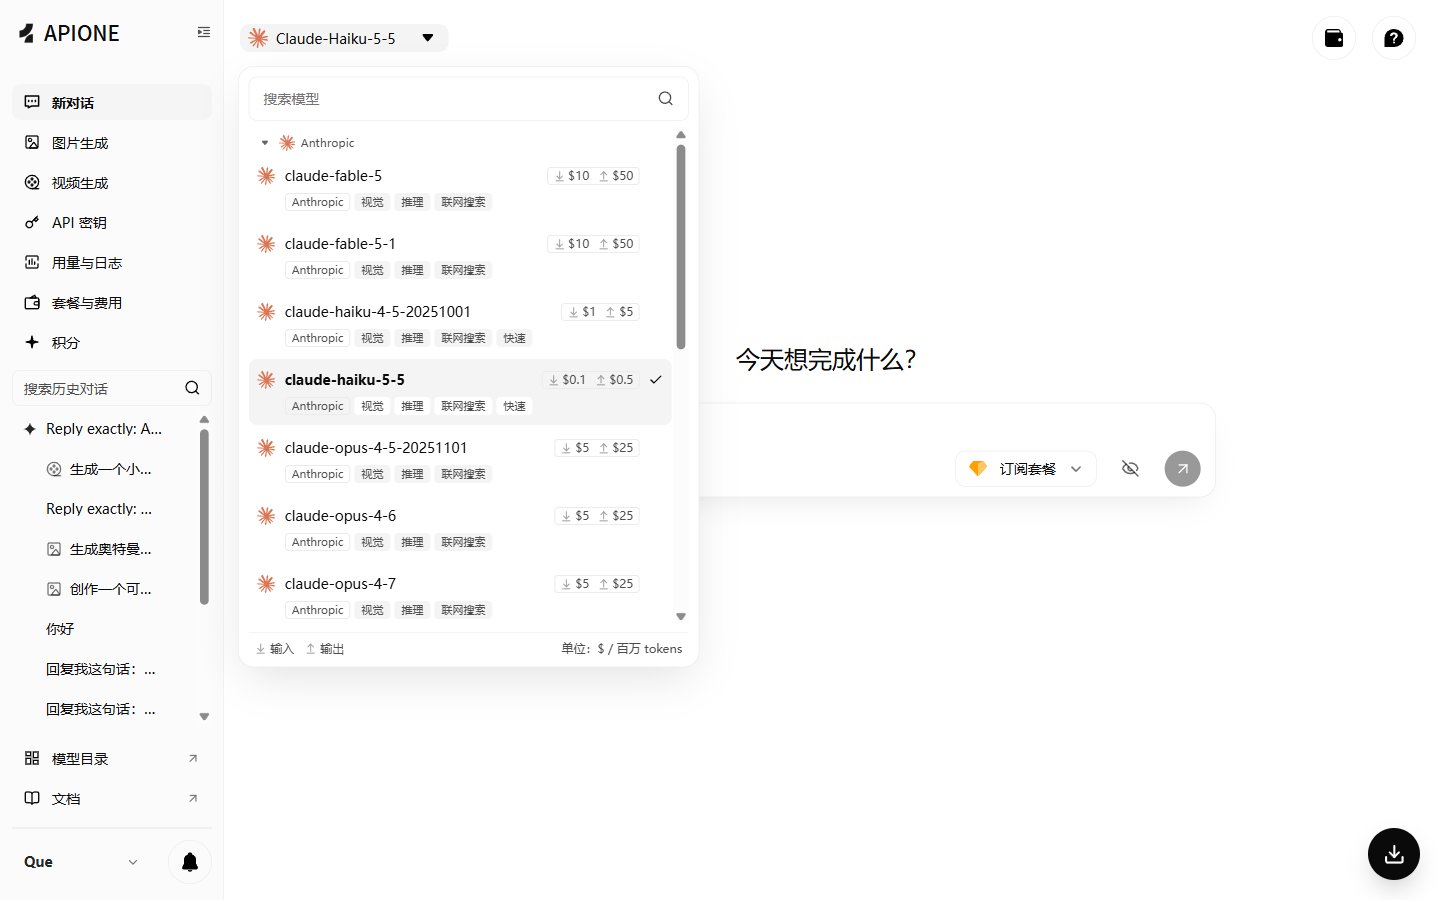
网页端模型选择器会同时展示模型厂商、能力、上下文和输入输出价格。
协议对照
Chat 还是 Responses
- 新接入的通用对话、流式输出和工具调用,可先使用 Chat Completions。
- 已使用 OpenAI Responses SDK 或 Codex 的项目,使用 Responses。
- 不要只为更换模型而改写协议。先保持现有请求格式,再替换模型 ID。
客户端地址速查
先打开对应工具教程,再填写该工具要求的基础地址。确认实际请求路径中 API 版本只出现一次。
保存配置后,先验证模型列表,再发送一条真实消息。在 APIONE 请求明细中确认调用成功后,继续启用工具、图片或其他能力。
选择前检查
- 调用
GET /v1/models,确认当前 Key 可用的模型 ID。 - 调用
GET /v1/models/{model}/params,确认模型声明的参数。 - 先发送最小文本请求,再逐项启用流式、工具、图片或其他能力。
- 在控制台请求明细中确认真实调用成功和实际费用。
配置项怎么填
如果客户端只有“API 地址”而没有说明是 Base URL 还是完整端点,先查该客户端教程。最常见的错误是把
.../v1/chat/completions 填进会自动追加 /chat/completions 的 SDK,最终形成重复路径。
按使用场景选择
已有代码项目
保持原 SDK 和请求结构不变,只替换地址、密钥与模型。先不要同时修改流式、工具调用、重试策略和输出格式;一次只改一类配置,便于定位问题。第三方客户端
优先选择客户端提供的 OpenAI Compatible、自定义 OpenAI 或 New API。Claude Code 使用 Anthropic 原生协议,Codex 通常使用 Responses。客户端能够保存配置并不等于模型已经连通,必须发送一条真实消息验证。新项目
- 普通对话和广泛兼容:从 Chat Completions 开始。
- 已采用 OpenAI 新版工作流:使用 Responses。
- Claude 原生消息与工具格式:使用 Anthropic Messages。
- Gemini 原生内容结构:使用 Gemini generateContent。
最小验证顺序
- 使用同一 Key 调用
/v1/models,确认网络、鉴权和权限。 - 复制准确的模型 ID,不手工猜测版本号。
- 只发送一条文本消息,不附加工具、图片或高级参数。
- 保存 HTTP 状态、响应正文和
X-Maxx-Request-ID。 - 最小请求成功后,再逐项启用流式、结构化输出、工具或多模态输入。
常见选错方式
下一步:地址与鉴权、快速开始、从其他平台迁移。