

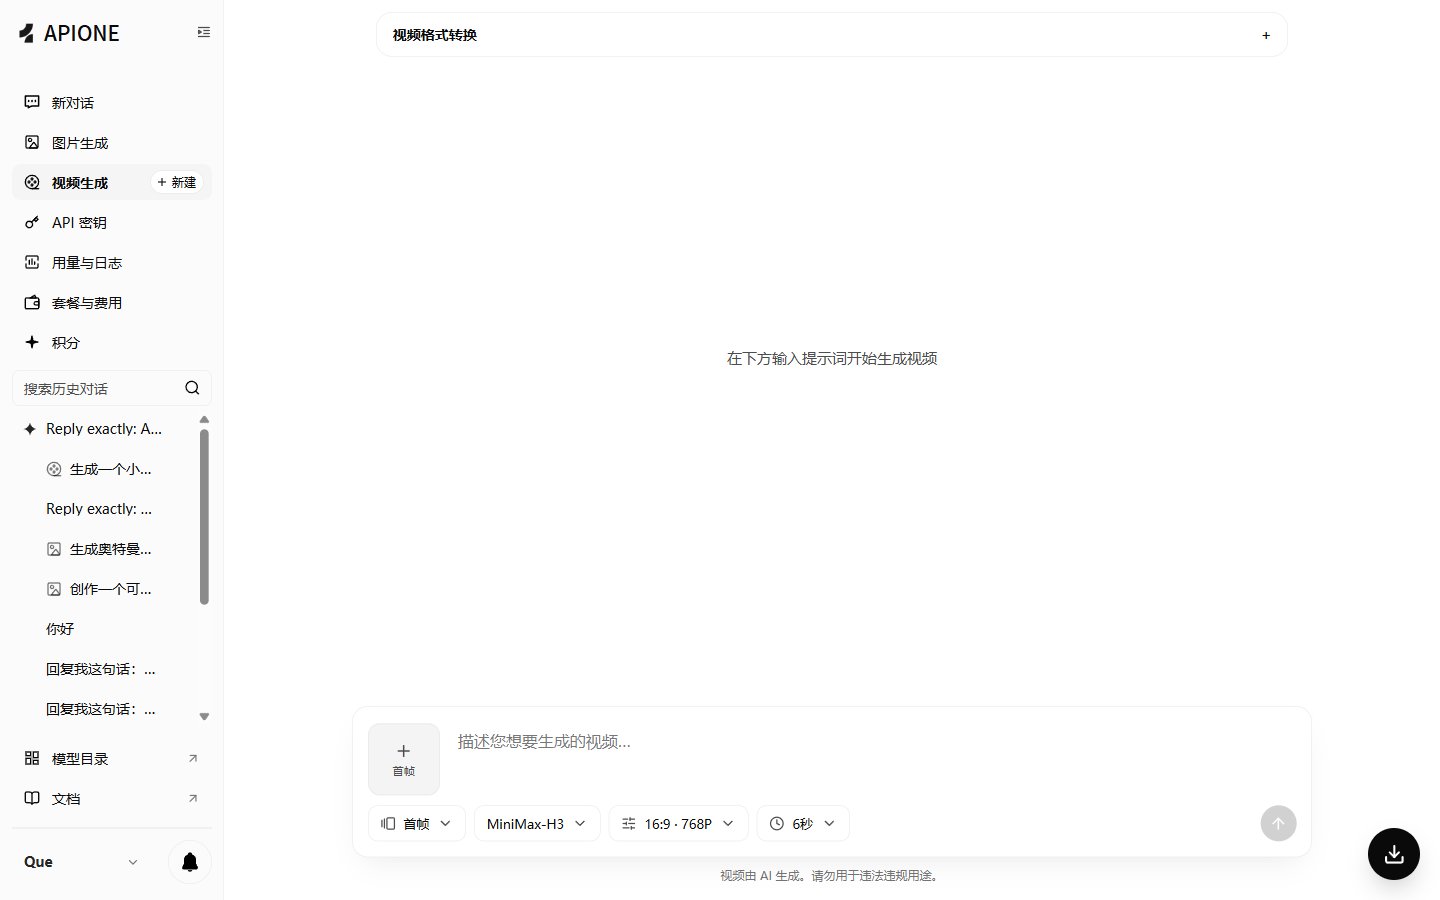
网页端视频生成集中设置生成模式、模型、画幅、分辨率和时长。
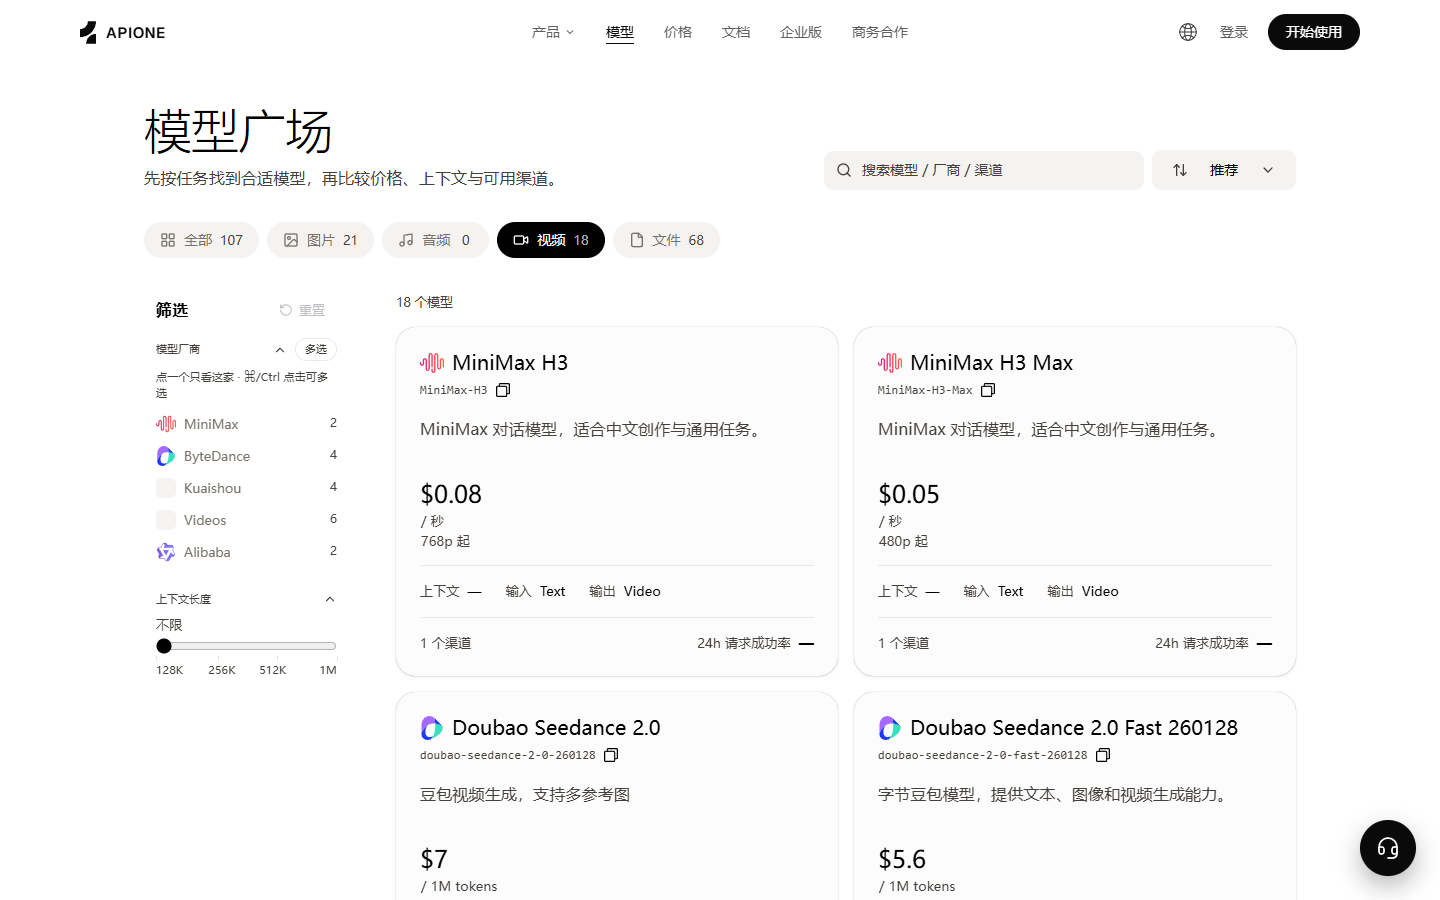
模型广场的视频分类展示可用视频模型、计费单位、输入输出类型和渠道。
/v1/models,确认列表包含目标视频模型,并核对该模型的创建、状态和结果字段。列表没有视频模型时,先在控制台检查 Key 分组与权限,不要使用其他渠道的模型 ID 或响应格式代替。
运行示例前准备
安装 Python 3,并在运行脚本的同一个 Python 环境安装依赖:python3,安装和运行时都使用 python3。Windows 也可以对应使用 py -m pip install requests 与 py example.py。使用虚拟环境时,先激活环境。
在 API 密钥页创建密钥,从当前 Key 可用的模型列表复制支持视频生成的模型 ID,然后在运行脚本的终端设置变量。下面的大写值是占位符,需要替换。
- macOS / Linux
- Windows PowerShell
1. 查询模型参数
2. 创建任务
3. 查询状态
4. 获取结果
任务完成后,从状态响应读取结果地址或结果对象。下载后在自己的存储中保存;结果地址的有效期以实际响应和模型规则为准。失败处理
- 参数错误:查询模型参数,修正字段后重新创建。
- 内容拒绝:调整提示词或参考素材。
- 上游失败:记录任务 ID 与请求 ID,在合理等待后有限次数重试。
- 状态长期不变:停止高频轮询,携带任务 ID 联系支持。
任务生命周期
Python 创建示例
Node.js 查询示例
使用 Node.js 18 或更高版本(内置fetch)。在创建请求的响应中找到实际任务 ID,设置 APIONE_VIDEO_TASK_ID 后再查询;它与模型 ID、请求跟踪 ID 不同。查询时沿用创建任务使用的 API Key。
example.mjs。在已设置本页所需环境变量的同一终端运行 node example.mjs。使用 Node.js 18 或更高版本,内置 fetch 无需额外依赖。
轮询策略
应用应设置固定或逐步增加的间隔,并设置最大等待时间。例如首次等待数秒,再根据任务耗时逐步降低查询频率。若状态响应提供建议等待时间,优先采用响应值。 轮询代码需要处理:网络失败、429、5xx、未知状态、用户取消、页面刷新和服务重启。任务 ID 应持久化,不能只放在浏览器内存中。结果下载
任务完成后先检查结果对象是否存在,再下载文件。下载完成后验证 HTTP 状态、文件大小、媒体类型、实际时长和能否解码。需要 MOV 时,如果模型只返回 MP4,应在自己的处理链中转码,而不是只修改扩展名。批量生成建议
- 先单条验证,再逐步增加并发。
- 每个业务任务使用自己的本地 ID 和状态机。
- 限制账户级并发,避免媒体任务挤占文本请求。
- 记录每个任务的模型、参数摘要、费用和结果路径。
- 对失败任务分类统计:参数、内容审核、上游、超时、下载失败。